首页 / 装进 ComfyUI:第一次跑通
装进 ComfyUI:第一次跑通
一、环境:先把卡认出来
ComfyUI 本身好装,麻烦的是显卡栈。AMD 卡在 Linux 上要走 ROCm,三件事按顺序做:
- 装 ROCm 与 PyTorch(ROCm 版)。版本要匹配,我这里是 PyTorch ROCm 6.3 + gfx1100(RX 7900 XTX)。装成 CPU 版的典型表现是「能启动但慢到不可用」。
- 把当前用户加进 render 组。不加,程序打开
/dev/kfd会失败,报权限错误。加完要重新登录一次。 - 给 ComfyUI 设好动态库路径。让 torch 自带的 ROCm 库优先于系统库,否则会出现版本冲突导致的启动崩溃。
# 1) 验证卡被 PyTorch 认到
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.get_device_name(0))"
# 期望输出: True AMD Radeon RX 7900 XTX

# 2) render 组
sudo usermod -aG render $USER     # 之后重新登录生效

# 3) 动态库路径(写在启动脚本或 systemd 单元的 Environment 里)
export LD_LIBRARY_PATH=/path/to/venv/lib/python3.*/site-packages/torch/lib:$LD_LIBRARY_PATH
N 卡用户把上面三步换成 CUDA 版 PyTorch 即可,第 2 步不需要。
二、装 ComfyUI 并做成服务
我用虚拟环境装,方便和系统 Python 隔离:
cd ~/comfy
python3 -m venv venv && source venv/bin/activate
pip install -r ComfyUI/requirements.txt        # 国内可加 -i 阿里云镜像
python main.py --listen 127.0.0.1 --port 8188
因为这台机器还要跑别的模型服务,我把它做成了 systemd 服务,好处是可以和本地大模型互相让位(详见第 6 节):
[Unit]
Description=ComfyUI
Conflicts=llama-server.service

[Service]
Type=simple
User=ubuntu
WorkingDirectory=/home/ubuntu/comfy/ComfyUI
Environment=LD_LIBRARY_PATH=/home/ubuntu/comfy/venv/lib/python3.11/site-packages/torch/lib
ExecStart=/home/ubuntu/comfy/venv/bin/python main.py --listen 127.0.0.1 --port 8188
Restart=on-failure
[Install]
WantedBy=multi-user.target
三、首次启动自检
启动后先确认三件事,顺序别乱:
# 1) 服务活着,端口在听
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8188/system_stats   # 期望 200

# 2) 提速内核被认到(A 卡很关键,没认到会慢很多)
journalctl -u comfyui -n 50 | grep -i "native ops"

# 3) 显存基线干净
rocm-smi --showmeminfo vram | grep -m1 'VRAM Total Used'
第 2 步的意义:ComfyUI 会检测有没有可用的量化内核(我这台是 int8_tensorwise 与 convrot_w4a4)。如果日志里没有这一行,说明内核没被启用,同样的参数你会比别人的速度慢一截,而错误信息不会告诉你原因。
第 3 步是习惯问题:跑之前显存应该是接近空的。如果显示还剩 20 GB 被占用,先去看本地大模型是不是没停。
四、H3 的链路:13 个节点
H3 在 ComfyUI 里的结构和你熟悉的其他视频模型不太一样,最明显的一点是:提示词不是喂给 CLIPTextEncode,而是直接写在主生成节点里。完整链路如下(取值是我实际在用的):
| 节点 | 关键取值 | 作用 |
|---|---|---|
| UNETLoader | minimax_h3_fl2va_pruned_fp8_scaled.safetensors | 加载 20 GB 底模 |
| LoraLoaderModelOnly | 4step Turbo,strength 1.0 | 4 步加速 |
| CLIPLoader | qwen3vl_32b…nvfp4_awq,type=minimax | 文本编码器;type 必须选 minimax |
| MiniMaxH3SigmaShift | shift_video 12.0 / shift_audio 3.0 | 音视频分开的 schedule 漂移,H3 特有 |
| MiniMaxH3ImageToVideo | prompt、width 768、height 768、length 64 | 主生成节点(文生/图生共用) |
| CLIPTextEncode | 空文本 | H3 不需要在这里写提示词 |
| KSampler | steps 4、cfg 4.0、euler、simple、denoise 1.0 | 采样 |
| VAELoader ×2 | 视频 VAE(fp16)+ 音频 VAE(fp32) | 两个 VAE 分开 |
| VAEDecode | — | 画面解码,最吃显存的一步 |
| VAEDecodeAudio | — | 声音解码 |
| CreateVideo | fps 24、bit_depth 8 | 把帧序列合成视频 |
| SaveVideo | format mp4、filename_prefix | 落地到 output/ |
第一次跑建议直接照抄这组取值:768 × 768、64 帧、4 步。它不是最好看的参数,但它是这台机器上唯一反复验证过能出片的组合。
五、三种提交方式
- 网页拖进去:打开
127.0.0.1:8188,把工作流 JSON 拖进画布,按 Queue。适合调试参数。 - 放进工作流目录:把 JSON 放到
ComfyUI/user/default/workflows/,刷新后能在界面里直接选。适合固定下来的几套流程。 - 用 API 提交(推荐):工作流存成 API 格式 JSON,用 curl 提交。可以写脚本批量跑、可以做队列、可以接自动化,我第一次跑通用的就是这条路。
# 提交任务
curl -s -X POST http://127.0.0.1:8188/prompt \
  -H 'Content-Type: application/json' \
  -d "{\"prompt\": $(cat /home/ubuntu/comfy/workflows_api/漫剧分镜_文生视频H3.json)}"
# 返回: {"prompt_id": "...", "number": 1, "node_errors": {}}

# 查状态(没跑完返回空 {})
curl -s http://127.0.0.1:8188/history/<prompt_id>

# 看产出
ls -lat ~/comfy/ComfyUI/output/ | head -3
注意 node_errors:如果它不是空的,任务根本没进队列,别在那儿等进度条。
六、跑通的标准:用 ffprobe 验,不要靠肉眼
「看起来有画面」不等于跑通。我用 ffprobe 验证每个字段——分辨率、帧率、时长、有没有音轨:
ffprobe -v error -show_entries format=duration,size -show_entries \
  stream=codec_name,width,height,r_frame_rate,channels \
  -of default=noprint_wrappers=1 漫剧_h3_t2va_00001_.mp4
我这边一条 768 × 768 × 64 帧的输出,实测是这样:
| 字段 | 实测值 | 说明 |
|---|---|---|
| video codec | h264 | 浏览器和剪辑软件都能直接吃 |
| 分辨率 | 768 × 768 | 和参数一致 |
| 帧率 | 24 fps | CreateVideo 里的值 |
| 时长 | 3.042 秒 | 64 帧 ÷ 24 fps ≈ 2.67 秒,多出来的是容器时间轴对齐 |
| 音频 | aac,2 声道 | 有音轨才算真跑通 |
| 体积 | 3.13 MB(约 8.2 Mbps) | 3 秒素材的量级参考 |
「64 帧看起来是 2.67 秒,实际文件 3.04 秒」这件事值得提前知道:你要 3 秒镜头就用 64 帧,不要按 24 帧 × 3 秒 = 72 帧去凑,H3 对帧数的取值是分档的(64、124 这些档位),不是任意数。
如果视频能播但没有声音,先看 VAEDecodeAudio 有没有连到 CreateVideo 上——这是这套链路最容易漏掉的一根线。
七、启动期常见错误
| 现象 | 原因 | 处理 |
|---|---|---|
| 启动就崩,报找不到 .so | LD_LIBRARY_PATH 没设或顺序不对 | 让 torch 自带的 ROCm 库排在系统库前面 |
| 报 /dev/kfd 权限不足 | 用户不在 render 组 | usermod 加组后重新登录 |
| 能启动但慢得离谱 | 装了 CPU 版 torch,或量化内核没启用 | 重装 ROCm 版 torch;日志里确认 native ops 那行 |
| 下拉框里没有模型 | 模型放错目录 | 回上一篇的目录结构 |
| 提交后队列空、history 也是空 | 进程崩过,systemd 重启会把队列清空 | 看日志尾最后一行 Requested to load,定位是哪个组件加载失败 |
八、耗时参考
| 阶段 | 768 档(4 步) | 720p 满血(20 步) |
|---|---|---|
| 模型加载(编码器 + 底模) | 57 秒 | 约 1 分钟 |
| 采样 | 1 分 49 秒(4 步) | 约 12 分钟(20 步) |
| 双 VAE 加载 + 解码 + 合成 | 52 秒 | 主要耗时 |
| 合计 | 236 秒 | 约 21 分钟 |
九、这几个参数为什么是这些值
照抄之后最好知道每一项在干什么,改的时候才知道该动哪一个:
| 参数 | 取值 | 为什么 |
|---|---|---|
| cfg | 4.0 | Turbo 档下 cfg 偏低是正常的。往上拉不会更「听话」,只会让画面变硬、动作发僵。 |
| SigmaShift 视频 / 音频 | 12.0 / 3.0 | 画面和音频各有一套 schedule 漂移,是 H3 特有的双通道设计。把音频改成和画面一样,声音会糊。 |
| denoise | 1.0 | 没有「在参考图上重绘」的需求就保持 1.0。调小等于让模型少改一点,结果通常是整体变糊而不是更稳。 |
| steps | 4 | 步数是跟着 LoRA 走的:4 步 LoRA 配 4 步。步数和 LoRA 不配套时,多跑的时间换不来画质。 |
| length | 64 | 帧数是分档的,别按 24 帧 × N 秒去凑。分档表和秒数换算见参数速查表。 |
| CLIPLoader 的 type | minimax | 这个选错不会给你友好的报错,可能只是编码结果不对、画面莫名其妙。 |
十、把流程脚本化
第一次跑通多用手点,之后就没人愿意点了。这套流程用 15 行脚本就能自动化:提交、轮询、取文件。
#!/bin/bash
WF=/home/ubuntu/comfy/workflows_api/漫剧分镜_文生视频H3.json

PID=$(curl -s -X POST http://127.0.0.1:8188/prompt \
      -H 'Content-Type: application/json' \
      -d "{\"prompt\": $(cat "$WF")}" \
      | python3 -c 'import sys,json;print(json.load(sys.stdin)["prompt_id"])')
echo "任务已提交: $PID"

while true; do
  R=$(curl -s "http://127.0.0.1:8188/history/$PID")
  [ "$R" != "{}" ] && break
  sleep 20
done

ls -lat /home/ubuntu/comfy/ComfyUI/output/ | head -3三个注意点:轮询给 20 秒够了(768 档一条 236 秒,1 秒一次只是白刷);一次只排一个任务,显存只有一份,排两个就是互相抢;取文件比等状态可靠,history 有时会被服务重启清掉,看 output 目录里的新文件最实在。
十一、跑通实测:236 秒一条,附三条判定证据
下面是 2026-09-18 22:39 那次完整成功记录,参数就是上一节那套:768 × 768 × 64 帧、4 步 Turbo LoRA、cfg 4.0、seed 12345。提交方式用工作流 API + 自己写的运行器:
python3 ~/.hermes/scripts/h3_run.py \
  --wf workflows_api/漫剧分镜_文生视频H3.json \
  --width 768 --height 768 --length 64 --steps 4 --seed 12345 \
  --prefix h3_768x768x64
分段耗时(与 ComfyUI 服务日志时间戳一一对应):
| 阶段 | 耗时 | 日志时间 |
|---|---|---|
| 入队 → 文本编码器开始加载 | 6 秒 | 22:39:04 → 22:39:10 |
| 文本编码器加载(14,960 MB) | 17 秒 | 22:39:10 → 22:39:27 |
| 底模加载(19,985 MB) | 40 秒 | 22:39:32 → 22:40:12 |
| 采样 4 步 | 1 分 49 秒 | 22:40:12 → 22:42:01 |
| 音频 VAE 加载 + 解码(577 MB) | 6 秒 | 22:42:01 → 22:42:07 |
| 回收 3,374 MB → 视频 VAE 加载(4,966 MB)→ 逐帧解码 | 46 秒 | 22:42:07 → 22:42:53 |
| 合计(ComfyUI 自报 229.82 秒) | 236 秒 | 22:39:04 → 22:43:00 |
判定「跑通」的三条证据
显存不够时 ComfyUI 是整进程崩掉,/history 会一直返回空对象。所以「没报错」不能当成功,要同时拿到三条证据:
- 服务还活着:
systemctl is-active comfyui返回 active,进程没被 abort; - /history 里出现了这个 prompt_id:说明任务正常执行完,而不是被清队列;
- 产出目录多了一个提交前不存在的文件,且 ffprobe 能解出视频流。
第 3 条必须用「提交前后对比」,不能用 ls -t 取最新——目录里可能躺着上个月的文件,会把失败当成功。本次的证据:
新文件: /home/ubuntu/comfy/ComfyUI/output/h3_768x768x64_00001_.mp4
ffprobe: 768x768@24fps, 3.042 秒, 2.33 MB, 视频 h264 + 音频 aac
▲ 本站同一台机器生成的 3 秒成片(带声音),未做任何后期。
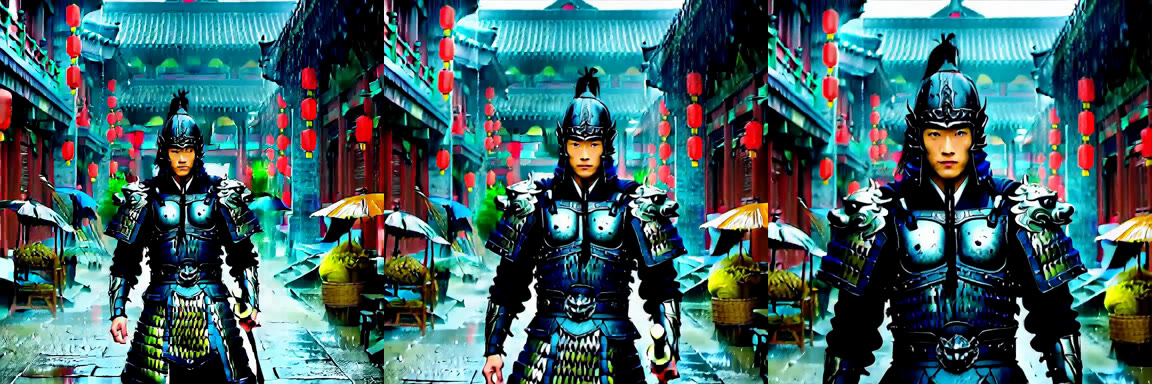
抽帧对照(第 0 / 24 / 48 帧):
说清楚它「能到什么程度」
这条片子是跑通级,不是能用级。4 步 Turbo LoRA 的代价很直观:
- 提示词里写了
rain,画面里几乎没有雨丝,只有地面反光; - 写了
walking,但三帧之间人物姿态几乎没变,运动主要是镜头推近; - 脸、甲胄、背景摊位的细节偏糊,帧与帧之间细节不稳定,颜色偏过饱和。
提质两条路:换 8 步 LoRA(动作更连贯,显存与耗时都上升),或者走 20 步满血档(约 21 分钟一条)。所以「跑通」的准确含义是:链路、显存余量、验证方法都对了,出片质量取决于挂几步的 LoRA——先把链路跑通,再决定为质量花多少时间。
十二、第二次启动的检查清单
- 服务在跑:
systemctl is-active comfyui - 显存是空的:接近 0.5 GB,不是 20 GB
- 模型还在:上一次崩溃或清理磁盘后,确认文件没被动过(必要时跑 sha256)
- 日志尾干净:没有上一次运行留下的加载失败记录
- 参数没被带过来:上一条任务临时改过尺寸的话,提交前确认改回去了
这五条看完再提交,比事后排查「为什么崩了」省时间。跑通之后,你就有一台能自己出片的机器了——接下来才是真正花时间的部分:怎么写提示词、怎么控制运镜。
小结
环境认到卡、服务活着、内核启用、模型放对、参数照抄、输出用 ffprobe 验过——这六件事做完,才算真的「第一次跑通」。下一篇开始进入正题:文生视频怎么把画面和声音一起做出来,以及提示词在 H3 里的写法和其他视频模型有什么不同。